MatrAIx-Persona:人口规模人物画像仿真基础设施
一个把采样人物画像实例化为 LLM Agent、并在四类交互环境中跑可复现任务的开源评估基础设施。
1. 项目速览
MatrAIx-Persona 对应的仓库是 ,官方 README 给它的定位是「population-scale, persona-driven infrastructure」,用于以异构模拟用户评估 AI 系统与交互式产品。它的做法不是拿一个通用、可互换的测试用户去跑评测,而是把采样到的人物画像记录实例化为 LLM Agent,再让这些 Agent 在 Survey、AI Chatbot、Web、App 四类环境中执行可复现任务,其中 App 环境覆盖原生桌面与移动端,README 明确写到包含 macOS 与 iOS。
支撑这一切的是一套共享的人物画像 schema,共 1,290 个分类维度,覆盖背景、心理、能力与行为四个面向。人物画像的生成方式结合了依赖感知的合成流程与证据感知的人类 grounding,并且已经公开发布了一个经过确定性质量过滤的百万级核心集,即 Persona 1M。README 同时强调,共享遥测、任务自有验证与报告机制会把个体的响应与轨迹聚合到子群体和总体层面的发现上。
需要先厘清的一点是,README 把项目名与《The Matrix》做了类比,但其自身表述非常克制:这是一个对探索、压力测试与假设生成有用的模拟世界,不是真实人群证据的替代品。该边界声明出自 README;在本次已采集的其他官方文档中未重复或吸收这一免责表述。
2. 项目定位
从官方描述看,MatrAIx 是 population-scale、persona-driven 的评估基础设施,面向 AI 系统与交互式产品,使用 heterogeneous simulated users;与测试 generic 或 interchangeable user 不同,它把 sampled persona records 实例化为 LLM agents,并通过 reproducible tasks 运行。
仓库命名中的 -8B 后缀容易被读成模型规格,但本次已采集的官方资料中,并没有对权重文件、参数量、训练数据或基座模型来源给出说明。README 的核心叙事是关于 persona、任务环境与运行框架的,而不是关于某一个模型 checkpoint 的。因此,把它当成「下载权重即可本地推理」的项目来预期,与官方材料呈现的信息并不一致。
从 Releases 区域可以读到项目的时间线:2026-07-29 发布了一篇从人物画像走向模拟用户的位置说明;2026-07-31 将 Playground 与任务库开源,也就是当前这个仓库;2026-08-01 在 Hugging Face 发布 Persona 1M,约一百万条经过质量过滤的人物画像;2026-08-04 上传了技术报告,arXiv 编号为 2608.04205,标题为《MatrAIx: Simulating the World with 8.3 Billion Persona Agents》。这四条信息构成了项目当前的公开交付物边界。
3. 核心功能
人物画像 schema 与数据集。schema 是 1,290 个分类维度,落在 persona/schema/ 目录下;persona/ 目录同时承载数据集、合成/策展/验证流水线以及配套的作业脚本。已发布的 Persona 1M 是一个确定性的、经过质量过滤的核心集,README 说明它面向研究用途。
人物画像条件化的 Agent。仓库结构中的 environment/agents/ 被描述为「Persona-conditioned agents」,也就是把画像条件注入 Agent 的执行单元。这是「采样记录 → LLM Agent」这一步的落点。
四类任务环境。官方给出的参考任务模板分别是:Survey 对应 application/tasks/example-survey_product-feedback,Chat 对应 application/tasks/example-chat-api_support_chatbot,Web 对应 application/tasks/example-web-playwright_quote-choice,OS-app 对应 application/tasks/example-computer-use-linux_note-to-csv。任务规格本身由 application/task-spec/ 下的共享任务契约约束。
Playground 可视化运行器。它由后端 API 与前端组成,官方描述的能力是选任务、采样人物画像,并启动与 CLI auto 模式相同的 MatrAIx Playground 作业。
遥测、验证与报告。README 将「shared telemetry, task-owned verification, and reporting」并列为把个体结果连接到群体结论的机制。任务自有验证意味着校验逻辑由任务定义,而不是由统一的外部评分器决定。
4. 技术或工作流程
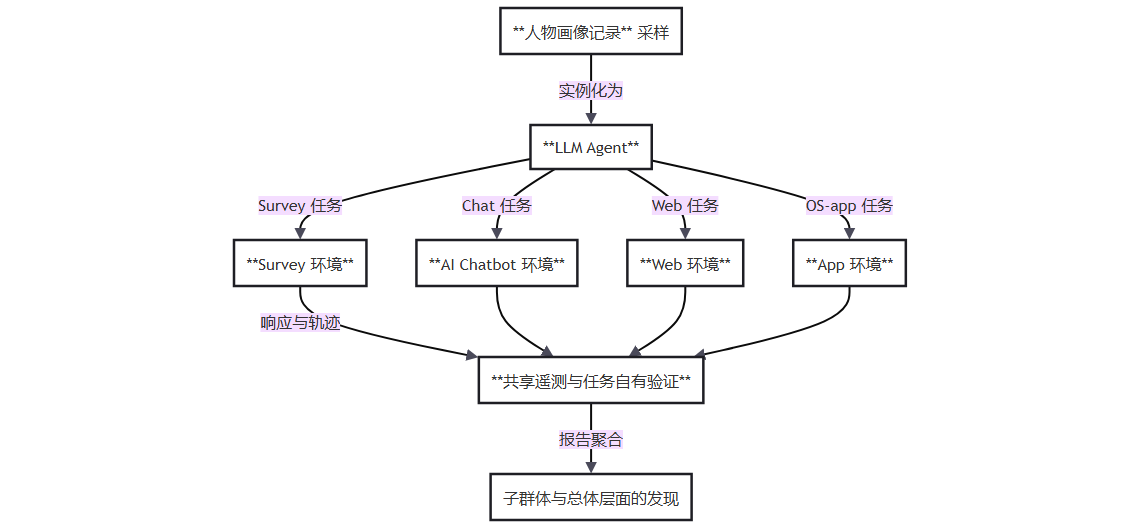
从官方 README 的描述可以还原出一条主干流程:采样人物画像记录,将记录实例化为 LLM Agent,让 Agent 进入四类环境之一执行任务,任务产生的响应与轨迹进入共享遥测与任务自有验证,最后由报告层聚合到子群体与总体层面的发现。
在工程侧,仓库把职责切成了几块:persona/ 管 schema、数据集与画像流水线;application/ 管任务规格、任务实现、Playground 与作业生成脚本;environment/ 管运行时、Agent、任务环境镜像/sidecar 以及外部适配器(例如 SimpleQA 适配器);packages/ 下是 playground、rewardkit、harbor-langsmith 三个包;apps/viewer/ 是与 harbor view 配对的前端;configs/jobs/ 存放整理好的与生成的作业配方;jobs/ 是本地运行输出目录,且被 gitignore。
任务开发与运行的链路也比较清楚。开发侧是复制一个参考任务目录到 application/tasks/<your-task-name>,再编辑 task.toml、instruction.md、input/ 与 verifier,并按 docs/application/task-guide.md 注册到 Playground。运行侧则是先用 application/scripts/generate_application_job.py 生成作业配方,该脚本会固定 agent 与模型,然后按脚本打印出的 export 行与配方路径执行 uv run matraix run -c …。README 也提示批量运行(--sample-size N)、过滤器以及其他环境的示例见 docs/quickstart.md。
5. 适用场景与落地建议
场景 1:调查问卷式评估
uv run matraix smoke application/tasks/example-survey_product-feedback 走无 Docker 的冒烟通道;实际运行时复制 application/tasks/example-survey_product-feedback 作为模板开发任务,或用 generate_application_job.py 搭配 --task、--execution-mode auto、--persona-ids、--model-name 生成配方后执行;Playground 中亦可在选定人物画像群组与 Survey 任务类型后执行 Lock pipeline 与 Run eval。场景 2:AI 聊天机器人评估
application/tasks/example-chat-api_support_chatbot;与 Survey 同属无 Docker 冒烟通道覆盖的范围,可通过 Playground 的 Chat 任务类型或 CLI 生成作业两种方式进入。docs/environment/agents.md,Playground 也可从 application/playground/.env.local 加载密钥。场景 3:Web 任务评估
application/tasks/example-web-playwright_quote-choice;该场景属于需要 Docker 的一侧,冒烟检查使用 uv run matraix run -c configs/jobs/example-job-recipe/harbor-smoke-local.yaml。jobs/harbor-smoke-local/。场景 4:桌面与移动 App 评估
application/tasks/example-computer-use-linux_note-to-csv;同样经由 Playground 的 OS app 任务类型或 CLI 作业进入。bash。6. 安装与运行要求
安装流程在 README 的 Installation 一节给出。先克隆仓库并进入目录,随后用 uv venv --python 3.12 创建虚拟环境,再依次执行 uv pip install -e .、uv pip install pytest pytest-asyncio httpx,以及三个子包的可编辑安装:packages/playground、packages/harbor-langsmith、packages/rewardkit。README 说明作业通过 uv run matraix run … 执行,已完成作业可用 uv run matraix results <job> 汇总,更底层的运行时工具保留在 uv run harbor … 之下。
人物画像是可选项但被标记为推荐:仓库内自带的 matraix-persona-dev-sample(约 200 条)仅用于冒烟,真实群组与 Playground 采样建议导入公开的百万级核心集,命令为 huggingface-cli download MatrAIx2026/MatrAIx_Persona_1M_Public_Release --repo-type dataset --local-dir persona/datasets/matraix-persona-1m/release。导入后在 Playground 中选择 matraix-persona-1m 数据集,或在 CLI 中用 --dataset persona/datasets/matraix-persona-1m 指定。
真实 GUI 或 CLI 运行前需要设置模型 API Key,README 给出的两个示例是 ANTHROPIC_API_KEY 对应 anthropic/claude-* 模型,OPENAI_API_KEY 对应 openai/gpt-* 模型;冒烟检查不需要密钥。GUI 路径分两个终端:一个执行 VENV=.venv bash application/playground/backend/run_dev.sh 启动 API,另一个在前端目录执行 npm ci && npm run dev,然后打开 http://localhost:5173,依次选择人物画像群组、任务类型、Lock pipeline、Run eval。
7. 环境、硬件或依赖
官方 Requirements 一节列出的依赖是四项:Docker(Web 与 OS-app 任务需要)、uv 与 Python 3.12、Node.js 20+(仅用于 Playground/viewer 前端),以及真实人物画像运行所需的模型 API Key。安装检查不需要 Key。
平台方面有一条硬性说明:Windows 用户需要在 WSL2 中运行全部操作,先执行 wsl --install 安装 Ubuntu,再把仓库克隆到 WSL 文件系统内(README 举例为 ~/MatrAIx,并指出 /mnt/c/… 慢得多),最后在 Docker Desktop 的 Settings → Resources 中开启 WSL 集成。README 明确写出原生 PowerShell/cmd 不受支持,理由是任务 verifier 需要 bash。
硬件方面存在信息缺口:在本次已采集的官方资料中未见明确说明 GPU、显存、内存或本地算力门槛。README 的依赖清单只覆盖软件与密钥,未给出硬件规格。这一缺口与项目当前的运行方式相关——真实人物画像运行依赖模型 API Key,而多环境任务通过 Docker 镜像与 sidecar 承载。
8. 已知限制
第一,边界声明是写进 README 的:MatrAIx 是用于探索、压力测试与假设生成的模拟世界,不是真实人群证据的替代品。任何把仿真结果直接当作人群结论的用法,都超出了官方材料自身的表述。
第二,平台限制明确。Windows 下必须走 WSL2,且要把仓库放在 WSL 文件系统内,Docker Desktop 需开启 WSL 集成,原生 PowerShell/cmd 不支持。
第三,数据侧有分层。仓库内的 matraix-persona-dev-sample 约 200 条,官方说明其用途仅限冒烟;用于真实群组的是需要单独下载的 Persona 1M。README 也说明大型生成数据集不进入 git,而是放在 Hugging Face 发布。
第四,许可范围存在分层。根目录的 LICENSE 是 MIT,标注 Copyright (c) 2026 MatrAIx,README 的 License 一节写的是「MIT — see LICENSE」;packages/rewardkit/LICENSE 则是 Apache License 2.0 全文。在本次已采集的官方资料中,未见对仓库其他子目录许可范围的逐项说明,因此不宜把根目录的 MIT 直接当作全仓统一授权的结论。
第五,硬件与性能指标在本次采集的官方资料中未见明确说明,包括推荐的 GPU 配置、显存占用、单任务耗时基准等。
9. 青峰联创分析
从工程角度看,这个项目最值得注意的不是某个模型,而是它把「人物画像 → Agent → 环境 → 遥测与验证 → 群体聚合」串成了一条端到端链路,并且把每一环都放在仓库里可见的位置:persona/schema/、environment/agents/、application/tasks/、packages/rewardkit 各司其职。这种切分方式意味着接入方可以先只替换其中一环,比如保留官方 schema 与任务库、只换掉 Agent 侧模型,而不必重写整条流水线。这一点可能对想要复用评估口径的团队有实际价值。
另一处值得注意的是任务模板的可复制性。官方把 Survey、Chat、Web、OS-app 四类各自给了一个参考任务目录,并给出「复制目录 → 编辑 task.toml/instruction.md/input/verifier → 注册」的开发路径。这是一条相对低门槛的扩展入口:新增一类任务不必从零搭建执行框架。不过需要提醒的是,README 给出的复制命令与生成脚本示例属于「示例」性质,其中的 --persona-ids 0042 是单个画像 ID 的示范值,--model-name anthropic/claude-sonnet-4-6 也是示例取值,并不代表默认配置。
关于适用判断,我们建议分两步走。第一步做零成本验证:先跑无 Docker 的那条冒烟命令确认 Survey 与 Chat 通道可用,再按需跑 Docker 那条确认 Web 与 OS-app 通道,这两步都不需要 API Key。第二步再评估数据与模型成本:如果只是验证流程,仓库内约 200 条的开发样本足以支撑;如果要做成群组的模拟评估,则需要导入 Persona 1M,并准备好模型 API Key。在本次采集的官方资料中,尚未见到关于大规模运行成本或并发能力的量化说明,因此容量规划需要以自测数据为准。
最后关于定位预期。README 在项目名类比说明中写明,该模拟世界对探索、压力测试与假设生成有用,但不是真实人群证据的替代品。从该表述看,官方更倾向于把项目放在假设生成与压力测试的位置上。对研究、产品早期验证这类可以容忍偏差、需要快速遍历可能性的环节,这种基础设施的适配度可能更高;而对于需要对外发布的人群结论,仿真结果应当被视为待验证的输入,而不是终点。至于仓库名中的 -8B,在本次已采集的官方资料中未见对权重与基座模型的具体说明,建议不要据此推断部署形态或推理方式。
10. 信息来源
👇 扫码/添加下方海报获取更多实操项目 👇